🧭这个分类到底在解决什么问题
先建立判断框架,再挑选工具——顺序反过来会浪费大量时间
看榜单选模型是最常见的选型方式,也是最容易踩坑的方式。核心原因有三:其一,刷榜(数据污染)——训练数据里混进了测试题,分数虚高;其二,跑分与真实体验脱节——MMLU 高分不代表它写的中文文案能看;其三,任务不匹配——学术评测擅长考知识,但你的任务可能是格式遵循或长文一致性。
正确的用法是「榜单用来筛,自己的评测用来定」:先用公开榜单把候选范围从几十个缩到三五个,然后用你自己的真实任务、自己写评分标准跑一轮对比测试。这一轮测试的价值远超任何公开榜单——因为你的业务需求是独特的。
另外要理解不同榜单的分工:LMArena 是用户盲测投票(反映主观偏好)、Open LLM Leaderboard 是标准化学术测试(反映基础能力)、OpenCompass / C-Eval / SuperCLUE 是中文场景评测(对国内业务参考价值更高)。三类结合看,才能得到比较完整的画像。
🎯选型三步走
任何工具都先过这三道判断,能筛掉 80% 的错误选择
⭐精选 6 款详解
每款配真实产品界面图(点击可放大)、适合人群与上手要点。点标题右侧按钮直达官网。
 产品界面实拍
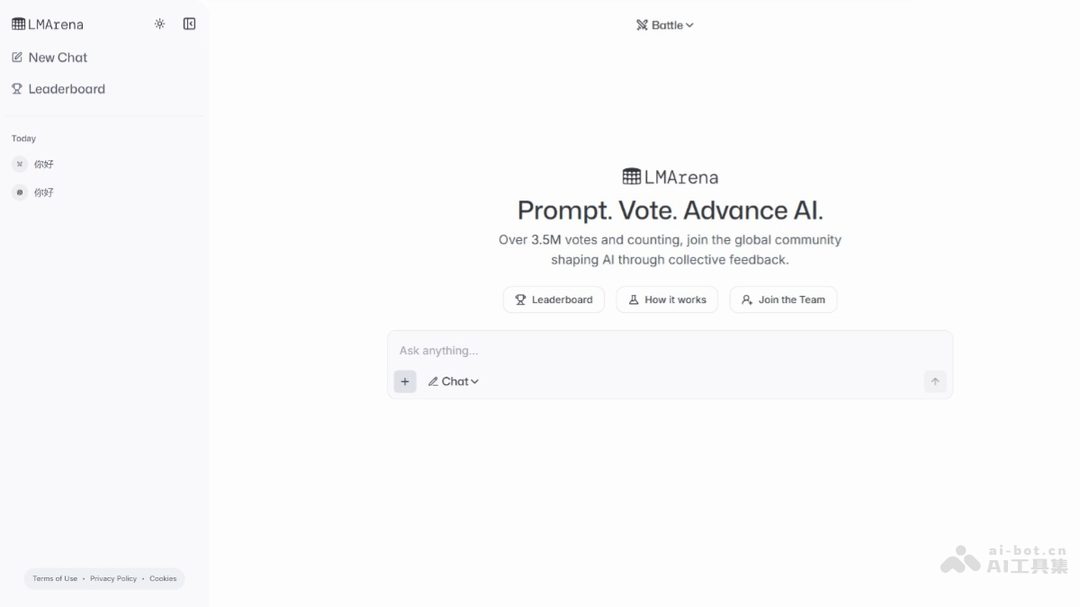
LMArena适合:想看「真实用户盲测偏好」的选型参考
LMArena是加州大学伯克利分校推出的创新AI模型评估平台,基于让用户对不同AI模型的回答进行匿名投票,衡量模型的表现。用户输入问题后,平台提供两个模型的回答,用户根据偏好选择更优答案,投票结果直接塑造公共排行榜。
- 它是用户盲测投票排名,反映的是「人们更喜欢哪个回答」,对交互类产品参考价值最高。
- 看分类榜单(代码 / 长文 / 中文 / 视觉)而不是只看总榜,你的任务属于哪类就看哪类。
- 盲测榜容易受「回答长、格式漂亮」影响,主观偏好不等于客观正确,注意区分。
 产品界面实拍
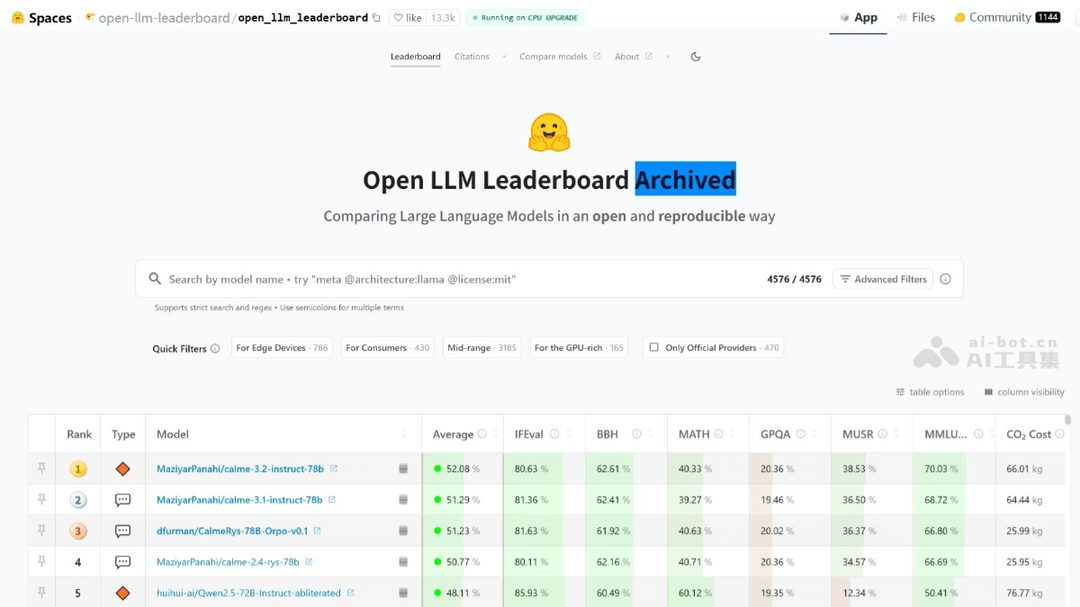
Open LLM Leaderboard适合:需要标准化学术基准数据的开源模型选型
Open LLM Leaderboard 是最大的大模型和数据集社区 HuggingFace 推出的开源大模型排行榜单,基于 Eleuther AI Language Model Evaluation Harness(Eleuther AI语言模型评估框架)封装。
- 适合比较同规模开源模型的基础能力,是筛掉明显不合格候选的高效工具。
- 注意它的测试集存在被训练数据污染的风险,分数异常高的模型反而要警惕。
- 结合模型规模看:同等分数下参数越小的越有部署优势,实际选型要综合成本。
 产品界面实拍
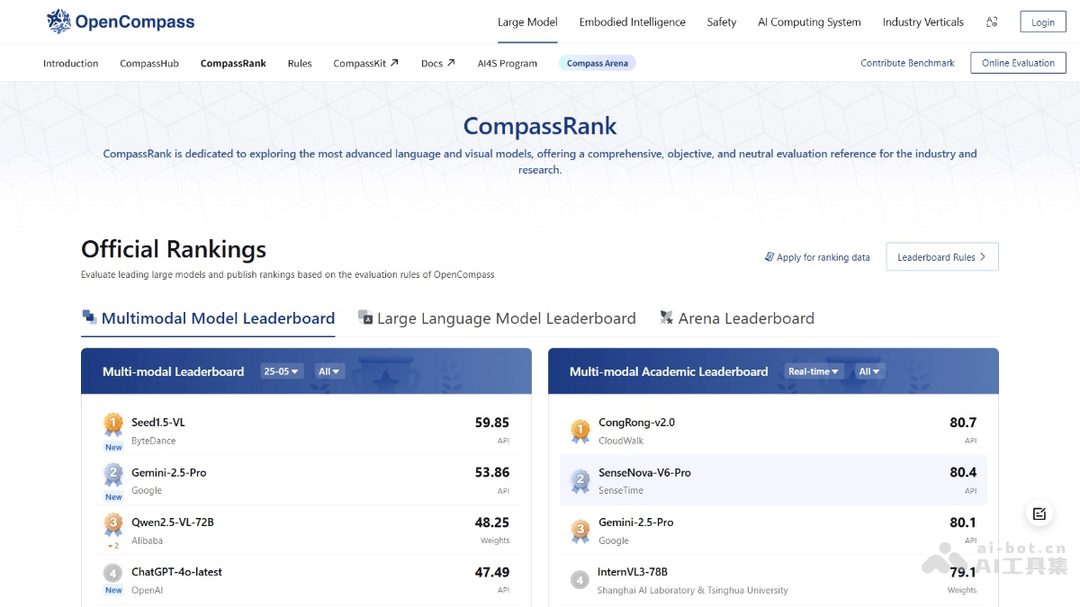
OpenCompass适合:中文场景下的模型对比与评测
OpenCompass是上海人工智能实验室(上海AI实验室)于2023年8月正式推出的大模型开放评测体系,通过完整开源可复现的评测框架,支持大语言模型、多模态模型各类模型的一站式评测,并定期公布评测结果榜单。
- 中文任务选型优先看它,中文语料下的表现比英文基准更有参考价值。
- 它的榜单维度较细(学科 / 语言 / 知识 / 推理),按你的任务类型对号入座。
- 可自建评测:把你的任务集上传跑一遍,得到贴合业务的对比结果。
 产品界面实拍
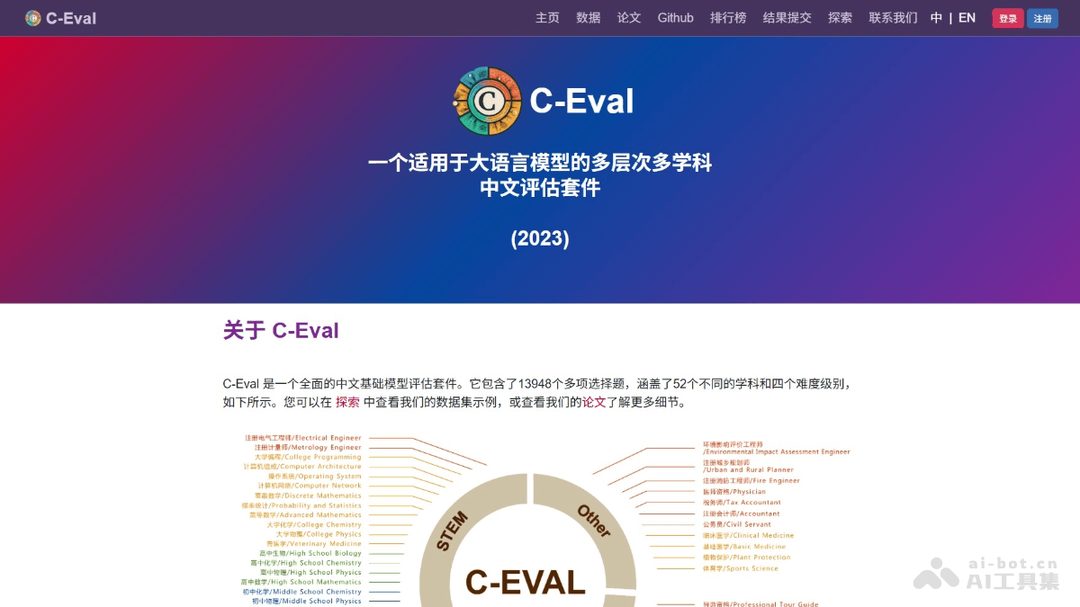
C-Eval适合:需要评估模型中文知识能力(尤其学科与专业领域)
C-Eval是一个适用于大语言模型的多层次多学科中文评估套件,由上海交通大学、清华大学和爱丁堡大学研究人员在2023年5月份联合推出,包含了13948个多项选择题,涵盖了52个不同的学科和四个难度级别,用以评测大模型中文理解能力。
- 适合评估模型在中文专业领域的知识储备,做教育、法律、医疗类应用时可作参考。
- 它偏知识问答,评估不了写作质量、格式遵循这类能力,别用它衡量所有维度。
- 分数相近时意义不大,只有差距明显时才值得作为选型依据。
 产品界面实拍
SuperCLUE适合:中文综合能力评测与行业应用参考
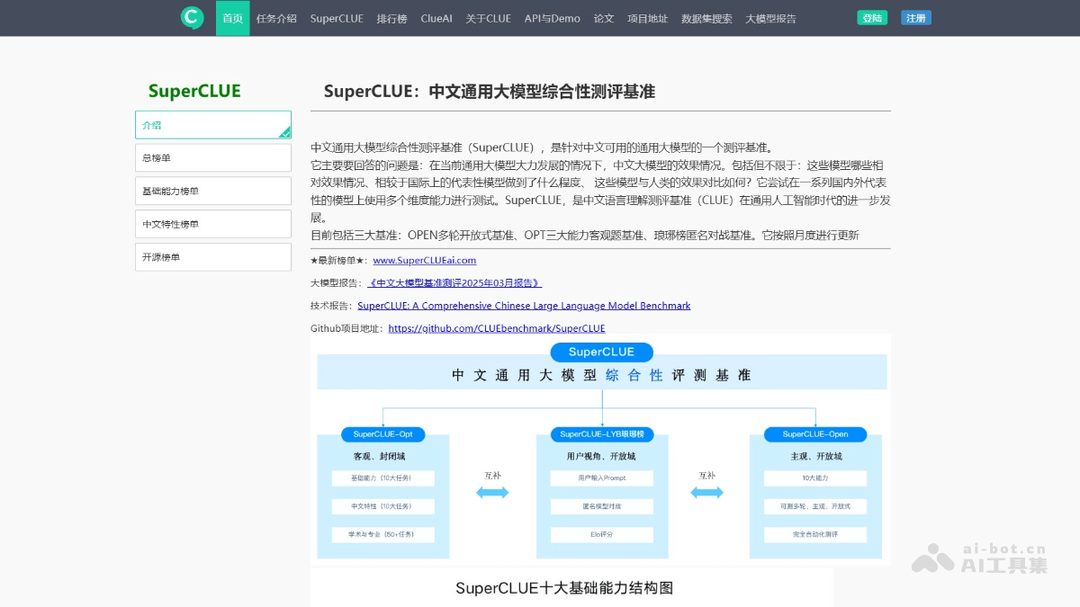
SuperCLUE 是针对中文大模型的综合性评测基准,能全面评估模型在多个维度上的性能表现。SuperCLUE 通过多轮对话、客观题测试等多种方式,从语言理解与生成、知识应用、专业技能、环境适应与安全性等四大能力象限的 12 项基础能力进行评估。
- 覆盖中文理解、生成、安全等多个维度,做中文产品的综合参考较全面。
- 关注它的分项报告:某个模型总榜一般但特定维度(如中文写作)可能很突出。
- 结合业务场景看分项,而不是只看总分排名。
 产品界面实拍
MMLU适合:需要评估模型通识知识与学科能力的基准
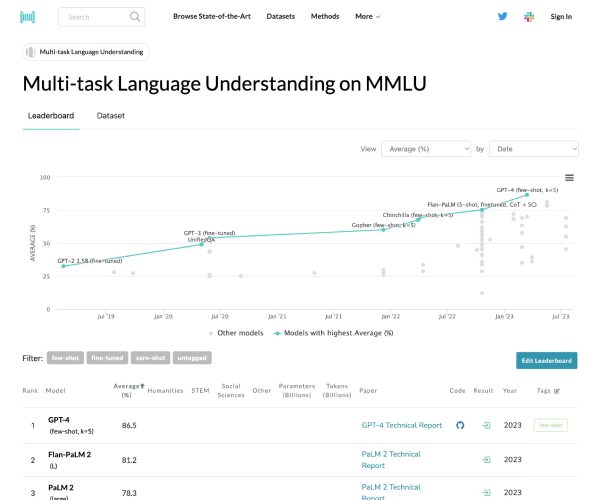
MMLU 全称 Massive Multitask Language Understanding,是一种针对大模型的语言理解能力的测评,是目前最著名的大模型语义理解测评之一,由UC Berkeley大学的研究人员在2020年9月推出。
- 它是「多学科选择题测试」,衡量的是知识广度,不是实际任务能力。
- 适合做学术对比和基准参考,但绝不能作为选型唯一依据。
- 对普通产品选型参考价值有限——用户不会给你出选择题,他们会提模糊的真实需求。
🛠️实操演示
从零到成品的完整步骤,照着走一遍就能上手
实操演示:给你自己的业务搭一套模型选型评测(半天完成)
演示工具:自建评测集的完整方法
- 1第 1 步:从真实任务取样
打开你的工单 / 聊天记录 / 邮件,随机抽 30–50 条真实需求。真实数据一定比编造的测试题有价值——它会包含口语化、信息不全、多意图混合这些真实难点。
- 2第 2 步:写评分细则
为每个任务写下「什么是好答案」的判断标准(3–5 条)。例如「包含三个要点 / 格式符合模板 / 没有编造数据」。有细则才能稳定打分,否则全凭手感。
- 3第 3 步:固定测试条件
所有候选模型用完全相同的提示词、相同的参数(温度设 0 减少随机性)、相同的输入。变量只有一个:模型。
- 4第 4 步:盲评打分
把模型名字隐藏,只看输出打分(1–5 分)。这一步很重要——知道品牌会显著影响你的判断。
- 5第 5 步:看总分,也看失败模式
除了平均分,重点看「哪些任务全部模型都失败」。如果所有模型都在某类任务上翻车,说明问题在你的提示词或任务设计,不在模型。
- 6第 6 步:把评测集变成资产
每遇到一个业务上的新难点,就补一条测试用例进去。半年后你手里会有一套极其贴合业务、比任何公开榜单都准的评测资产。
⚠️避坑清单
这些坑几乎每个人都会踩一次,提前知道能省下不少成本
- 只看总榜选模型是最常见的错误:总榜第一名在你的具体任务上可能是倒数。一定要用分项榜单 + 自建评测。
- 警惕跑分异常高的模型:明显超出同规模水平的分数,大概率是数据污染,而不是真突破。
- 参数设错会让评测完全失效:温度、最大长度、系统提示词不一致,比出来的结果毫无意义。测试条件必须完全固定。
📋该分类完整清单(15 款)
按收录顺序排列,查看全部 16 个分类总表
| # | 工具名称 | 一句话说明 | 直达 |
|---|---|---|---|
| 1 | MagicArena | 字节推出的视觉生成模型对战平台 | aigcarena.com |
| 2 | MMLU | 大规模多任务语言理解基准 | paperswithcode.com |
| 3 | Open LLM Leaderboard | Hugging Face推出的开源大模型排行榜单 | huggingface.co |
| 4 | C-Eval | 一个全面的中文基础模型评估套件 | cevalbenchmark.com |
| 5 | FlagEval | 智源研究院推出的FlagEval(天秤)大模型评测平台 | flageval.baai.ac.cn |
| 6 | SuperCLUE | 中文通用大模型综合性测评基准 | cluebenchmarks.com |
| 7 | AGI-Eval | AI大模型评测社区 | — |
| 8 | OpenCompass | 上海人工智能实验室推出的大模型开放评测体系 | opencompass.org.cn |
| 9 | CMMLU | 一个综合性的大模型中文评估基准 | github.com |
| 10 | MMBench | 全方位的多模态大模型能力评测体系 | mmbench.opencompass.org.cn |
| 11 | HELM | 斯坦福大学推出的大模型评测体系 | crfm.stanford.edu |
| 12 | LMArena | AI模型评估平台 | lmarena.ai |
| 13 | LLMEval3 | 由复旦大学NLP实验室推出的大模型评测基准 | llmeval.com |
| 14 | H2O EvalGPT | H2O.ai推出的基于Elo评级方法的大模型评估系统 | evalgpt.ai |
| 15 | PubMedQA | 生物医学研究问答数据集和模型得分排行榜 | pubmedqa.github.io |